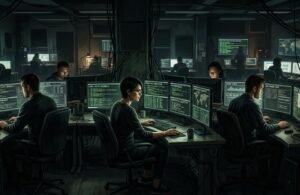
La delgada línea entre entrenar un algoritmo inteligente y exponer la privacidad de millones de usuarios en internet.
El factor humano detrás de la pantalla
Cuando interactúas con un chatbot de inteligencia artificial, la sensación de privacidad suele ser absoluta. Escribes tus dudas en un cuadro de texto vacío y recibes respuestas inmediatas, asumiendo que solo una máquina procesa tus datos. Sin embargo, la realidad detrás del telón tecnológico es muy diferente y requiere de una supervisión humana constante para que el sistema funcione correctamente.
A fecha de 14 de septiembre de 2026, la empresa OpenAI mantiene contratados a cientos de trabajadores externos dedicados exclusivamente a leer, analizar y calificar las conversaciones que los usuarios mantienen con ChatGPT. Esta práctica de control de calidad tiene como objetivo principal pulir las respuestas de la inteligencia artificial, pero también plantea serios interrogantes sobre la confidencialidad de la información confidencial de quienes interactúan con la plataforma.
¿Por qué este proceso afecta tu día a día?
La mayoría de los usuarios recurre a la inteligencia artificial para resolver tareas cotidianas, profesionales e incluso íntimas. Se redactan correos electrónicos corporativos, se consultan síntomas de salud, se analizan contratos comerciales complejos o se programan líneas de código propietario de empresas. Al introducir esta clase de información en el sistema, existe una probabilidad real de que un tercero lea detalladamente el texto original.
Esto no se debe a un fallo de seguridad del sistema o a un ciberataque externo. Se trata de un engranaje oficial y estructurado dentro del proceso de entrenamiento de la inteligencia artificial que la gran mayoría de los usuarios desconoce al aceptar los términos de servicio por defecto.
La analogía del diario vigilado
Imagina que decides comprar un diario personal protegido con un candado de alta seguridad para escribir tus reflexiones diarias más sinceras. Sin embargo, la empresa fabricante del diario envía a un revisor a tu domicilio todas las noches para abrir el cuaderno, corregir tus errores ortográficos y comprobar si el papel tiene la calidad adecuada. Aunque la intención de la empresa sea mejorar el producto, la privacidad de tus notas íntimas habría desaparecido por completo.
Este escenario es el equivalente exacto a lo que ocurre en el ecosistema de los modelos de lenguaje actuales. Los contratistas humanos actúan como esos revisores silenciosos que evalúan la calidad del texto intercambiado.
¿Cómo opera el sistema de evaluación humana?
El proceso técnico se basa en el aprendizaje por refuerzo a partir de la retroalimentación humana. Los contratistas reciben fragmentos de diálogos reales y su tarea consiste en evaluar si las respuestas de ChatGPT son precisas, seguras, neutrales y útiles. Los moderadores deben calificar las réplicas del software y reescribir las respuestas deficientes para enseñar al modelo la forma correcta de expresarse.
Aunque OpenAI sostiene que aplica potentes filtros automatizados para eliminar datos de carácter personal como números de teléfono, nombres completos o direcciones físicas, estos sistemas de cribado no son perfectos. En la práctica, gran cantidad de información detallada y contextualizada logra superar los filtros informáticos y llega directamente a los ojos de los revisores.
Los datos que escapan de los filtros automáticos
Los sistemas automatizados de filtrado de datos suelen fallar cuando la información sensible se presenta de forma indirecta. Por ejemplo, si un usuario describe un cuadro médico muy inusual detallando su profesión, su rango de edad y su localidad, un revisor humano con acceso a internet podría deducir la identidad del paciente sin necesidad de leer su nombre explícito.
De igual manera, el código de programación desarrollado para proyectos privados de empresas a menudo contiene referencias cruzadas que exponen la estructura interna de sistemas comerciales críticos. Esta información permanece en las bases de datos de revisión a las que acceden los subcontratistas externos.
Una práctica generalizada en el sector tecnológico
Es fundamental comprender que OpenAI no es la única compañía que utiliza este método de optimización. Otras grandes corporaciones tecnológicas del sector de la inteligencia artificial, como Google y Anthropic, recurren a metodologías idénticas de etiquetado de datos para mantener competitivos sus respectivos modelos lingüísticos. La dependencia de estos ejércitos de evaluadores humanos demuestra que, en la fecha de 14 de septiembre de 2026, la inteligencia artificial no es capaz de autoeducarse de forma totalmente autónoma.
Estos trabajadores suelen estar ubicados en países con costes laborales competitivos y realizan su labor a través de plataformas de microtrabajo subcontratadas. Soportan jornadas de alta presión donde deben calificar miles de interacciones diarias bajo acuerdos de confidencialidad difíciles de supervisar a gran escala.
Cómo puedes proteger tu privacidad de forma efectiva
Si deseas seguir aprovechando las ventajas de las herramientas de inteligencia artificial sin que tus datos personales acaben en las pantallas de terceros, te recomendamos aplicar estas medidas de protección inmediatas:
- Desactiva la opción de entrenamiento de datos en la configuración de tu cuenta de usuario para que tus chats no se almacenen con fines de mejora del modelo.
- Evita introducir datos financieros, contraseñas, documentos de identidad o detalles de proyectos corporativos confidenciales en la ventana de chat.
- Trata al chatbot como si estuvieras manteniendo una conversación abierta en un espacio público donde cualquiera podría escuchar tus palabras.
Creemos que hablamos con una máquina solitaria en la nube, pero en realidad compartimos nuestros secretos con una sala llena de revisores de contenido.