El procesamiento en el propio dispositivo gana terreno frente a la nube gracias a la necesidad de controlar los datos personales.
Un cambio de paradigma en la computación personal
El 12 de octubre de 2026 marca un punto de inflexión en la relación entre los usuarios y la inteligencia artificial.
Cada vez más personas eligen ejecutar modelos de inteligencia artificial en sus propios dispositivos en lugar de depender de servidores externos.
Esta tendencia responde a una inquietud creciente sobre la privacidad y el uso no autorizado de la información personal.
El problema de la nube y la pérdida de control
Durante los últimos años, el uso de herramientas digitales requería enviar datos a centros de procesamiento remotos.
Cada consulta, documento o imagen subida a la nube quedaba almacenada en servidores gestionados por terceras empresas.
Con el paso del tiempo, han aumentado las dudas sobre cómo se utilizan esos registros para entrenar nuevos algoritmos.
Esta falta de transparencia ha generado desconfianza entre los usuarios domésticos y profesionales.
Entender la IA local mediante una analogía
Imagina que para cocinar en tu casa tuvieras que enviar cada ingrediente a un restaurante ajeno y esperar a que te devuelvan el plato.
Si el restaurante cierra o cambia sus reglas, te quedas sin cenar y además ellos conocen exactamente qué ingredientes consumes.
Ejecutar tecnología en tu dispositivo es como instalar una cocina completa en tu propio hogar.
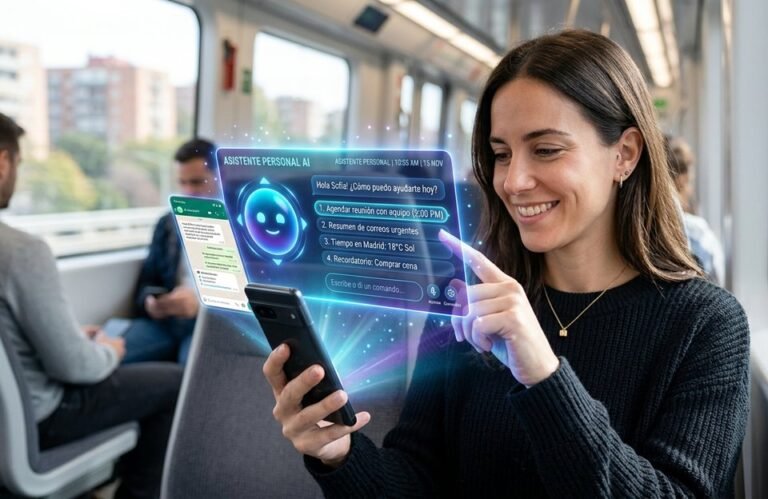
Esto es como si tuvieras un asistente personal instalado dentro de un archivador con candado al que solo tú tienes acceso.
El papel del hardware especializado
La transición hacia este modelo descentralizado ha sido posible gracias a las mejoras operativas en el hardware de consumo.
Los procesadores actuales incluyen unidades de procesamiento neuronal capaces de resolver operaciones complejas de forma eficiente.
Estas piezas reducen el consumo de energía y permiten obtener respuestas inmediatas sin necesidad de conexión a internet.
Sin embargo, adoptar esta tecnología requiere adquirir equipos con mayor capacidad de memoria RAM y potencia gráfica.
Desafíos técnicos y coste de adopción
Aunque los beneficios en privacidad son claros, la adopción total aún enfrenta barreras importantes.
El coste inicial de los dispositivos preparados para estas tareas sigue siendo superior al de los equipos básicos.
Además, la instalación de estos programas requiere ciertos conocimientos técnicos por parte del usuario final.
A pesar de estas dificultades, el interés por mantener el control absoluto de los archivos personales sigue impulsando la demanda.
Impacto en la vida diaria de los usuarios
Para el ciudadano común, disponer de modelos locales cambia la forma de gestionar la información confidencial.
Es posible resumir contratos, analizar borradores bancarios o redactar correos privados sin que ningún dato salga del teléfono o portátil.
Asimismo, la falta de dependencia de una conexión a red garantiza el funcionamiento continuo en zonas sin cobertura.
La velocidad de respuesta deja de depender del estado de los servidores centrales de una corporación.
“El verdadero avance de la inteligencia artificial a 12 de octubre de 2026 no es que sea más rápida, sino que por fin funciona dentro de tu propio equipo sin pedir permiso a nadie.”
Un futuro complementario entre la nube y el dispositivo
A pesar de esta gran adopción, los centros de datos remotos no van a desaparecer por completo.
Las investigaciones científicas y los análisis masivos de datos seguirán requiriendo la potencia de supercomputadores compartidos.
No obstante, para el uso cotidiano, la balanza se ha inclinado hacia la protección del entorno privado.
La privacidad ha dejado de ser una exigencia teórica para convertirse en el criterio principal de compra tecnológica.
Fuentes
Sombra Radio · Apoyo de lectores
Ayuda a mantener viva Sombra Radio
Tu aportación voluntaria nos ayuda a seguir publicando sobre IA. Puedes apoyarnos desde 1 € al mes.