Un análisis revelador demuestra que juntar múltiples agentes virtuales dispara el consumo de recursos sin ofrecer mejoras reales en el resultado final.
¿Alguna vez has intentado coordinar un trabajo en grupo donde hay más reuniones para decidir qué hacer que tiempo dedicado a trabajar?
Eso mismo está ocurriendo dentro de los servidores de la inteligencia artificial en este año 2026.
Durante mucho tiempo, la industria nos vendió una idea brillante: si un modelo de lenguaje es listo, diez modelos trabajando juntos serían sencillamente imparables.
Sin embargo, al abrir el capó de la tecnología, la realidad nos muestra un motor lleno de fricción y bastante costoso.
Un estudio publicado en octubre de 2026 por la firma Vals AI, respaldado por observaciones de investigadores de OpenAI, ha sacado a la luz los números reales de esta arquitectura.
El resultado es rotundo: los equipos de agentes de inteligencia artificial gastan una cantidad enorme de recursos para conseguir mejoras que apenas se pueden medir.
¿Qué es exactamente un equipo de agentes?
Para entender el problema, primero debemos mirar dentro de la maquinaria y definir las piezas.
Un modelo tradicional como ChatGPT funciona como un consultor individual: le haces una pregunta y te responde al instante.
Un “agente”, en cambio, es como un trabajador al que le das un objetivo y la capacidad de usar herramientas externas, como buscar en internet o ejecutar código por su cuenta.
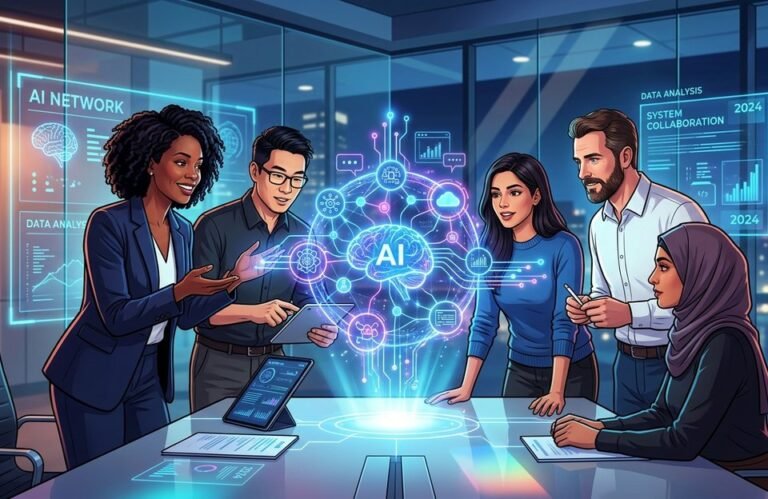
Ahora bien, imagina un “sistema multiagente”: es literalmente una oficina virtual repleta de estos trabajadores.
En teoría, tienes a un agente “investigador”, a un agente “redactor” y a un agente “revisor” conversando entre ellos para entregarte un informe perfecto.
Suena fantástico sobre el papel, pero el diablo está en los detalles de cómo se comunican estos sistemas por dentro.
El problema de los tokens y la gasolina digital
Cada vez que un sistema de inteligencia artificial lee o escribe una palabra, consume lo que en informática llamamos “tokens”.
Piensa en los tokens como las fichas de una máquina recreativa o como gotas de gasolina en el depósito de un coche.
Cada pensamiento intermedio, cada borrador y cada saludo que intercambian los agentes cuesta dinero y energía eléctrica.
En un equipo multiagente, el agente investigador escribe dos mil palabras y se las envía al agente redactor.
El agente redactor lee esas dos mil palabras, escribe quinientas y se las manda al revisor para que las evalúe.
El revisor encuentra un pequeño fallo, devuelve el texto al inicio y todo el ciclo vuelve a empezar desde cero.
Este proceso interminable genera lo que los expertos llaman el “coste de coordinación”.
Es el equivalente digital a la burocracia corporativa: se gastan horas en reuniones para decidir cómo hacer la tarea antes de ejecutarla.
Toda esa cháchara interna entre robots quema miles de tokens en silencio, pagados directamente por el usuario o la empresa.
Números que no salen a cuenta
El estudio de Vals AI puso a prueba esta dinámica analizando miles de tareas complejas.
Compararon el rendimiento de un solo agente bien configurado contra un enjambre de múltiples agentes colaborando.
Los datos mostraron que los equipos de agentes llegaron a consumir hasta un mil por ciento más de tokens que un solo agente.
¿Y la mejora en la calidad del resultado final? En la mayoría de las pruebas no llegó ni al tres por ciento.
Esto significa que estás pagando diez veces más gasolina para avanzar apenas unos centímetros más en la carretera.
El freno de mano de la experiencia: La latencia
Además del golpe al bolsillo, existe un factor técnico que destruye la experiencia del usuario: la latencia.
La latencia es el tiempo de espera, el cronómetro que corre desde que pulsas “Enter” hasta que la respuesta aparece en tu pantalla.
Cuando utilizas un solo agente, la respuesta viaja en línea recta y llega en pocos segundos.
Con un equipo de agentes, la respuesta tarda minutos porque los modelos deben esperar pacientemente el turno de palabra de sus compañeros virtuales.
Imagina pedir un café y que el camarero deba pedir autorización al barista, al cajero y al gerente antes de servirte la taza.
El café que te tomas es exactamente el mismo, pero has perdido diez minutos de tu vida esperando en la barra.
La trampa de la memoria a corto plazo
¿Por qué la colaboración entre inteligencias artificiales vuelve a los sistemas tan ineficientes?
La respuesta está en la “ventana de contexto”, que funciona como la memoria a corto plazo de la inteligencia artificial.
Conforme los agentes discuten entre sí, la memoria del sistema se llena de saludos, correcciones secundarias y paja verbal.
Llega un punto en que el modelo se distrae con su propio ruido interno, sufriendo lo que los ingenieros llaman degradación de atención.
Al final, tanta conversación cruzada hace que la inteligencia artificial pierda el foco de lo que realmente le habías pedido.
“Poner a diez inteligencias artificiales a debate no produce diez veces más genialidad; la mayoría de las veces solo produce una factura diez veces más cara.”
¿Hacia dónde va la arquitectura de la IA?
Esto no significa que la inteligencia artificial autónoma esté acabada, ni mucho menos.
Lo que la investigación demuestra en este año 2026 es que la solución no es añadir más burocracia virtual.
El futuro de la eficiencia pasa por perfeccionar las instrucciones y las herramientas de un solo agente centralizado.
Un solo modelo bien diseñado, con un flujo de trabajo claro, es más rápido, más barato y casi igual de preciso que todo un comité de bots.
Para quien usa la tecnología a diario, esto deja una enseñanza sumamente práctica.
No necesitas herramientas hipercomplejas ni pagar suscripciones carísimas que prometen “un equipo de expertos de IA a tu servicio”.
Aprender a dar instrucciones claras a un solo modelo sigue siendo la estrategia más inteligente y económica.
La próxima vez que veas una aplicación que presume de tener decenas de agentes trabajando en segundo plano, piénsalo dos veces.
Podrías estar pagando la fiesta privada de un grupo de robots que solo se escuchan hablar a sí mismos.
Fuentes consultadas
- The Decoder: AI agent teams waste massive tokens for barely measurable quality gains, research finds
Sombra Radio · Apoyo de lectores
Ayuda a mantener viva Sombra Radio
Tu aportación voluntaria nos ayuda a seguir publicando sobre IA. Puedes apoyarnos desde 1 € al mes.